Фотообзор инженерной инфраструктуры ЦОД Meta Prometheus в Огайо
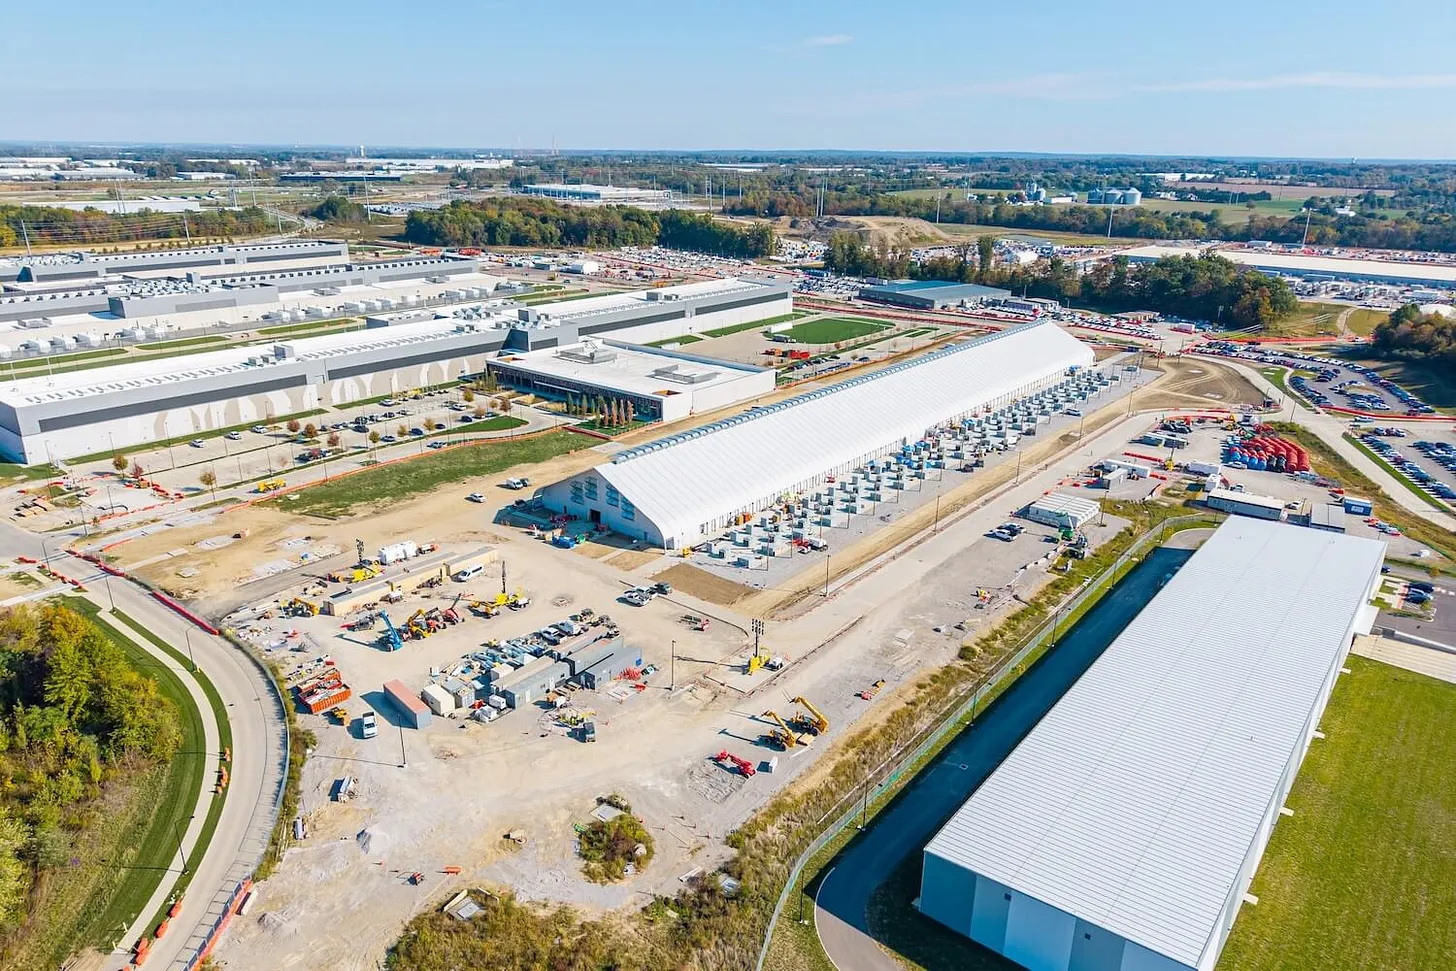
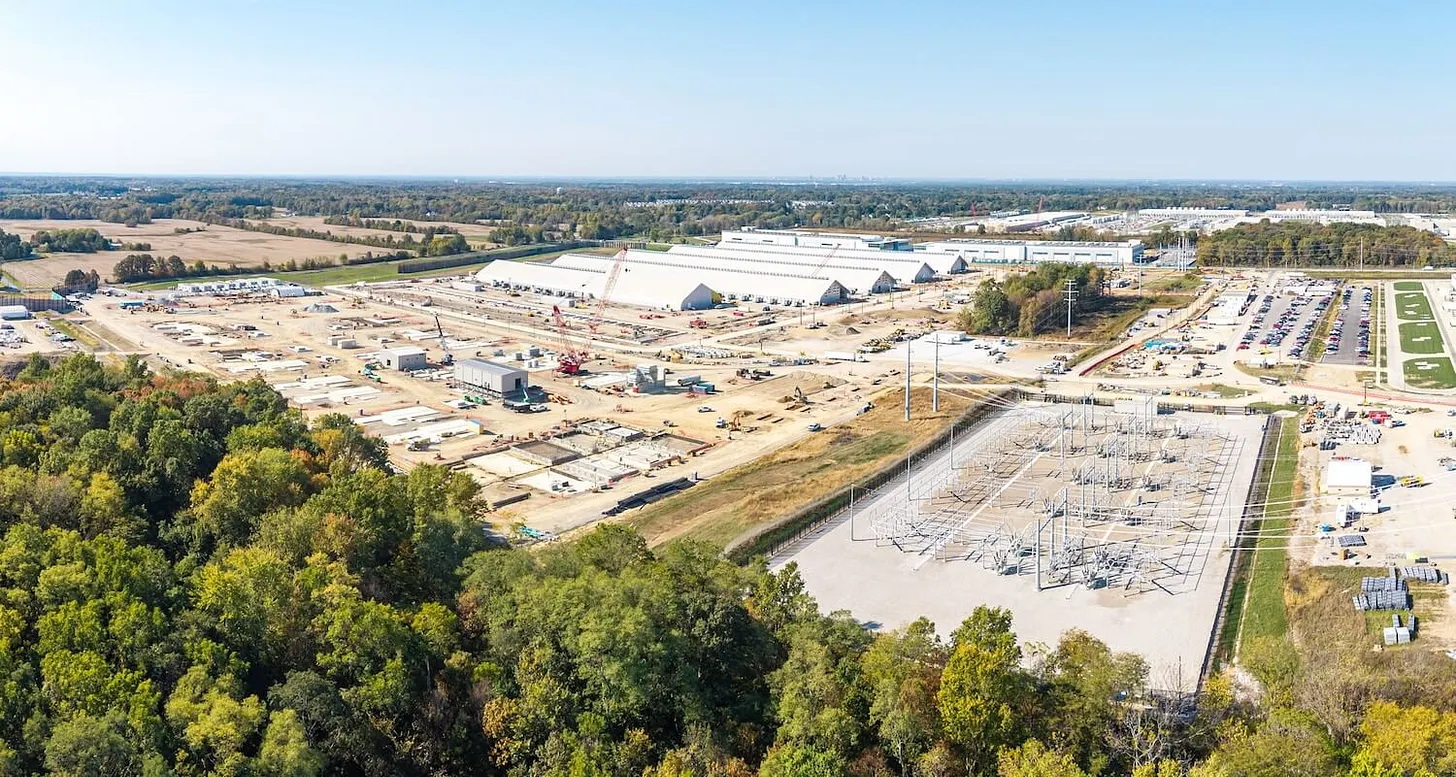
Американская Meta раскрыла подробности строительства и эксплуатации суперкомпьютерного комплекса гигаваттного масштаба Prometheus, расположенного в городе Нью-Олбани, штат Огайо (США).
Проект предусматривает объединение нескольких дата-центров в единую вычислительную инфраструктуру. Первая очередь комплекса уже введена в эксплуатацию и используется, помимо прочего, для обучения ИИ-моделей Muse.
Сейчас пул IT-систем Prometheus включает сотни тысяч графических процессоров, используемых для обслуживания ИИ. В перспективе их количество планируется увеличить примерно до миллиона. Особое внимание при развитии комплекса уделяется инженерным системам: охлаждению, электроснабжения и механизмам для ускорения ввода новых мощностей.
Архитектура комплекса и модульное строительство
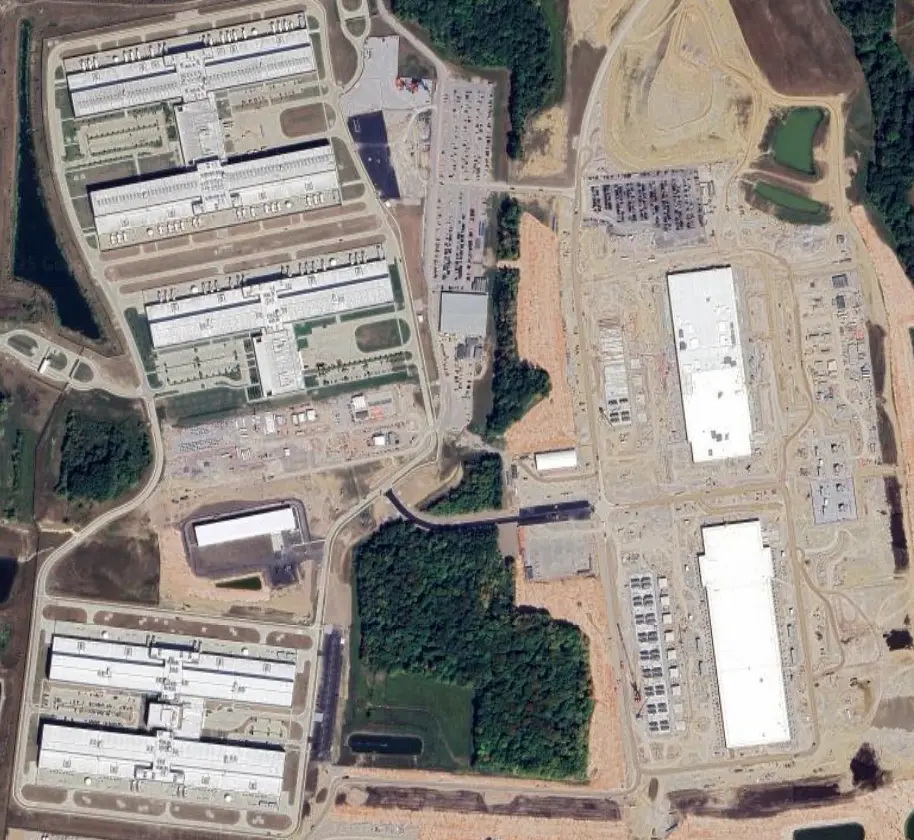
Изначально площадка в Нью-Олбани использовалась как стандартный дата-центр Meta. Для размещения современных ИИ-серверов существующую инфраструктуру модернизировали. Сегодня Prometheus объединяет три типа объектов:
- Традиционные дата-центры, переоборудованные для размещения высокопроизводительных вычислительных систем.
- Специализированные ИИ-ЦОД, изначально спроектированные под высокую плотность оборудования и жидкостное охлаждение.
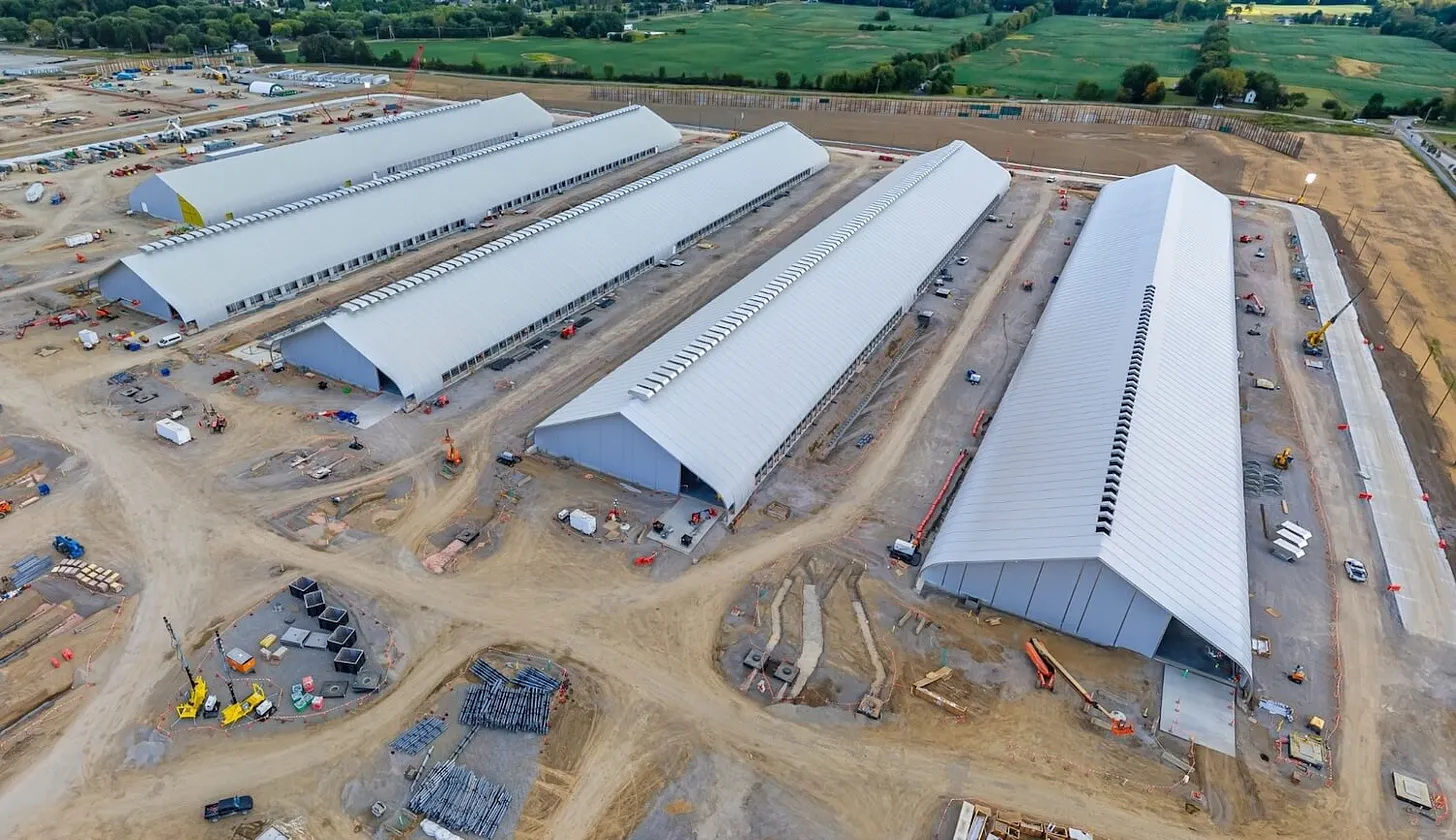
- Быстромонтируемые сооружения, позволяющие наращивать вычислительные мощности без ожидания завершения строительства капитальных зданий.
Охлаждение серверного оборудования
Для удаления тепла от высокопроизводительных GPU команда Meta использует несколько архитектур охлаждения:
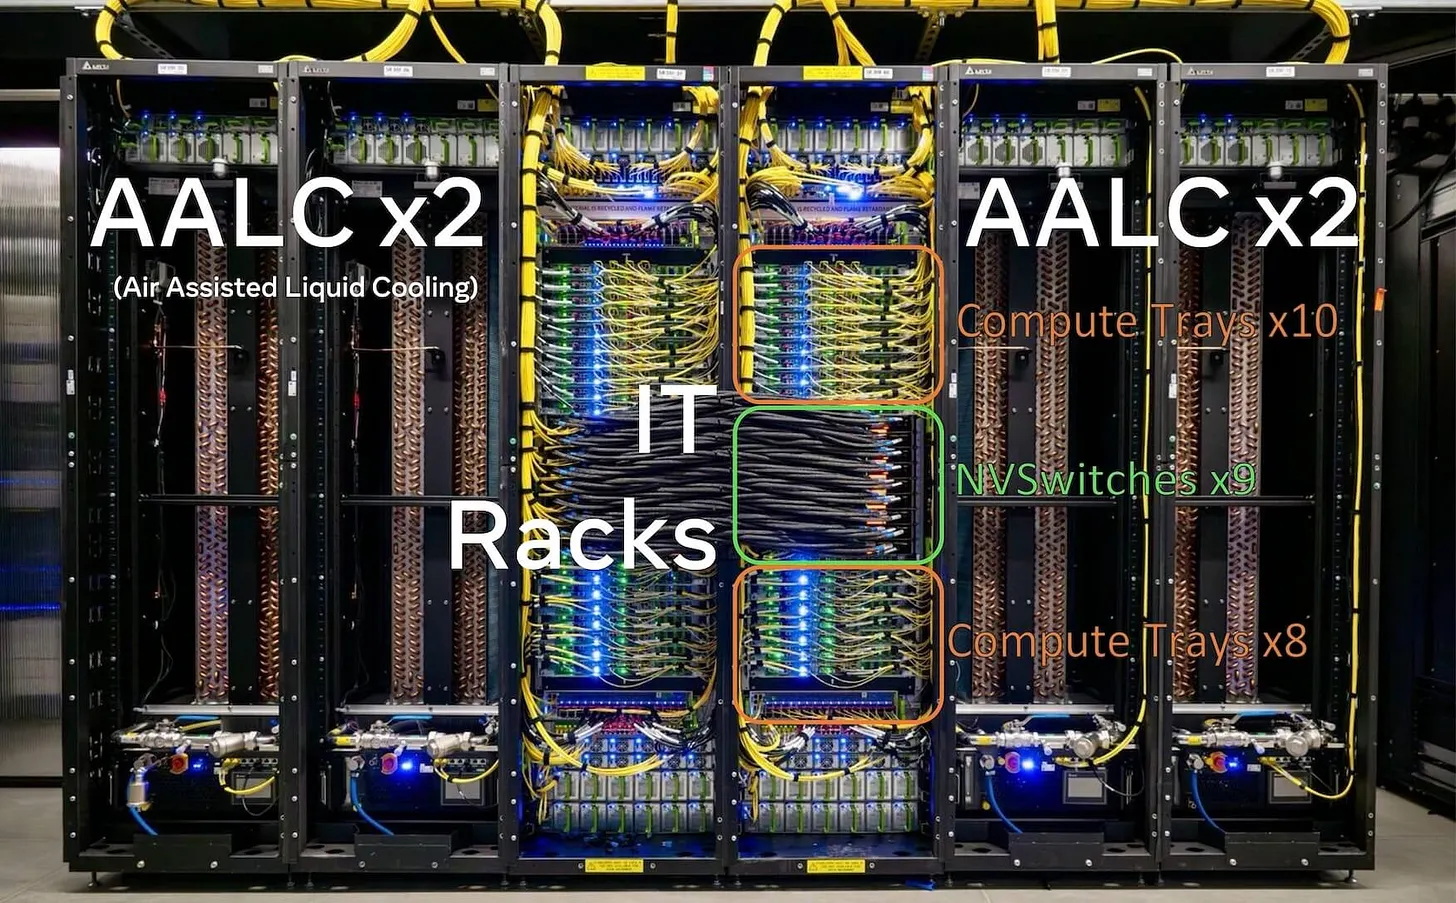
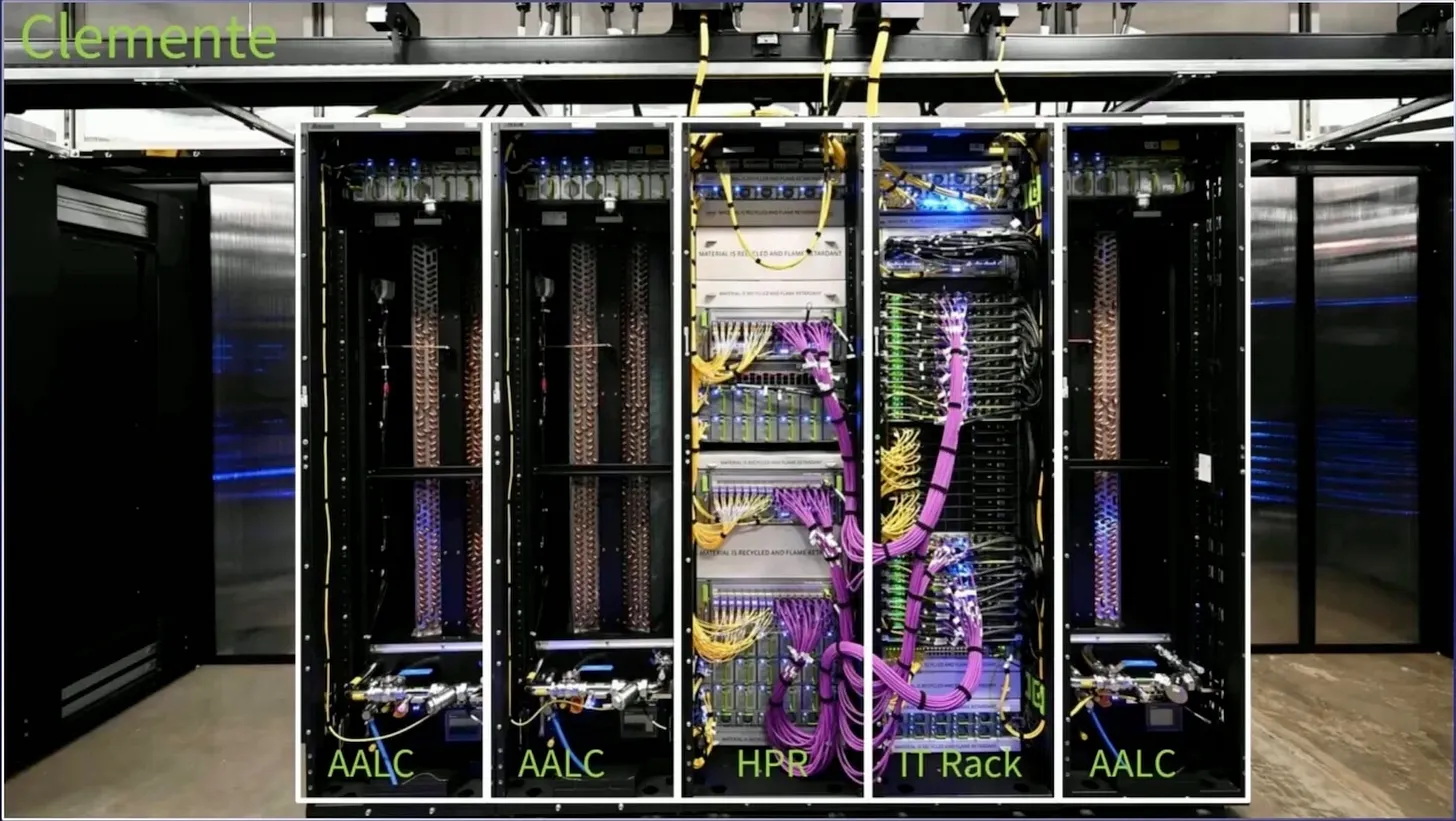
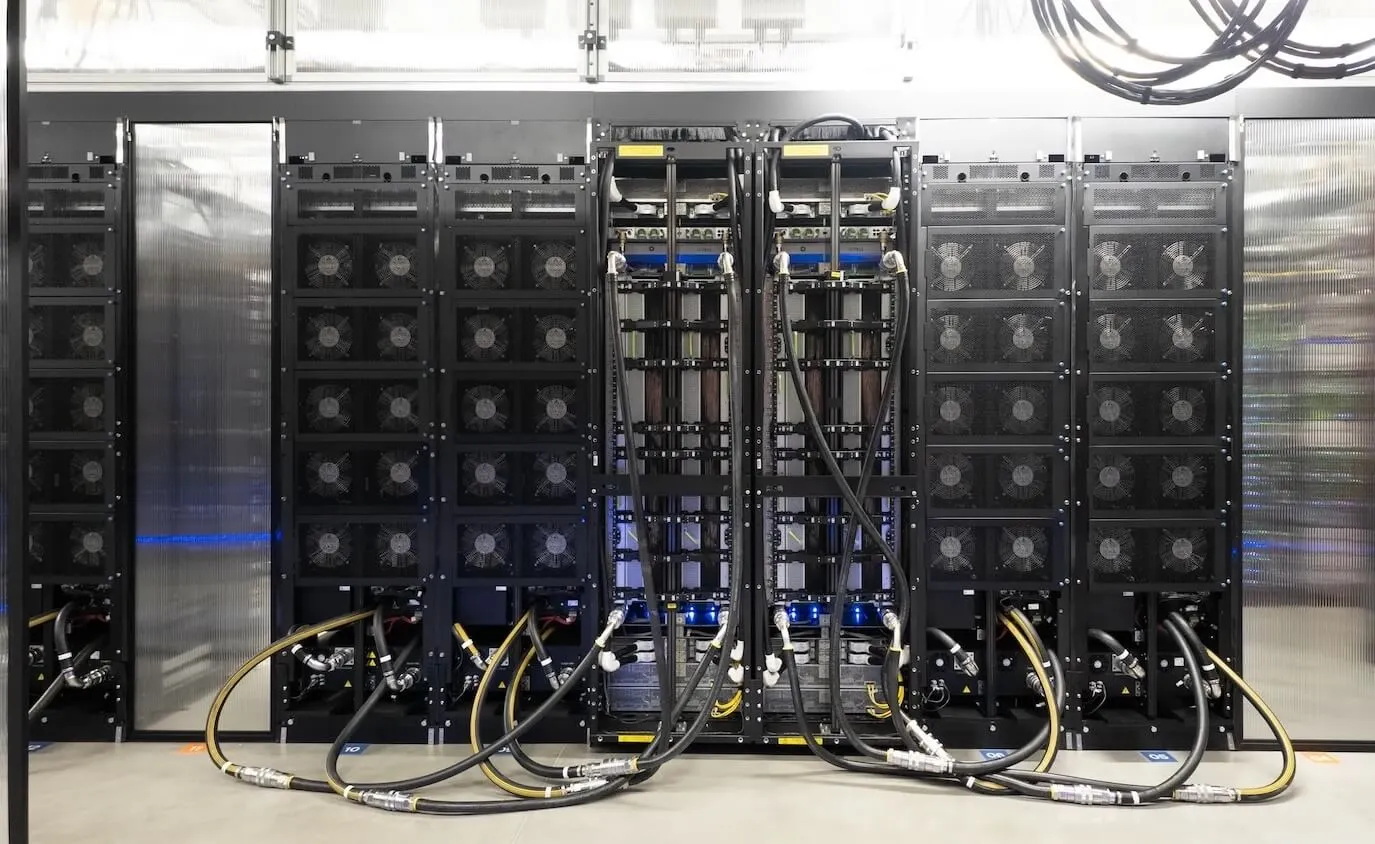
- Air-Assisted Liquid Cooling (AALC). Модульная система жидкостного охлаждения с воздушным теплоотводом. Она применяется в существующих дата-центрах и быстроразвертываемых сооружениях, позволяя адаптировать их к более мощному оборудованию.
- Facility Liquid Cooling (FLC). Система жидкостного охлаждения, интегрированная в инженерную инфраструктуру здания. Она используется в новых корпусах Prometheus, рассчитанных на максимально плотное размещение серверных стоек и комплектующих внутри них.
- Direct-to-Chip. В новейших зданиях также применяется прямое жидкостное охлаждение процессоров с замкнутым контуром циркуляции теплоносителя. Теплоотвод осуществляется через охлаждающие пластины, непосредственно контактирующие с нагревающимися компонентами. Такая архитектура уменьшает зависимость от воздушного охлаждения и позволяет размещать больше вычислительного оборудования на ограниченной площади.
При этом Meta уделяет особое внимание качеству сборки охлаждающих пластин и распределительных коллекторов (CDU), чтобы поддерживать стабильные температуры и предотвращать протечки.
Параметры серверных стоек и их влияние на инфраструктуру
В Prometheus используются платформы Nvidia разных поколений:
- GB200 NVL72 (Catalina). 72 GPU в двух стойках с общей потребляемой мощностью около 120 кВт. Возможно воздушное охлаждение.
- GB300 NVL72 (Clemente). 72 GPU в одной стойке с потреблением около 135 кВт. Возможна работа с AALC или FLC.
- Vera Rubin NVL72 (San Miguel). Перспективная платформа с полностью жидкостным охлаждением и потреблением более 170 кВт на стойку.
Инженеры отмечают, что переход к стойкам мощностью свыше 170 кВт требует не только более производительных систем теплоотвода, но и соответствующего развития электрической инфраструктуры дата-центров.
Электроснабжение и компенсация резких скачков нагрузки
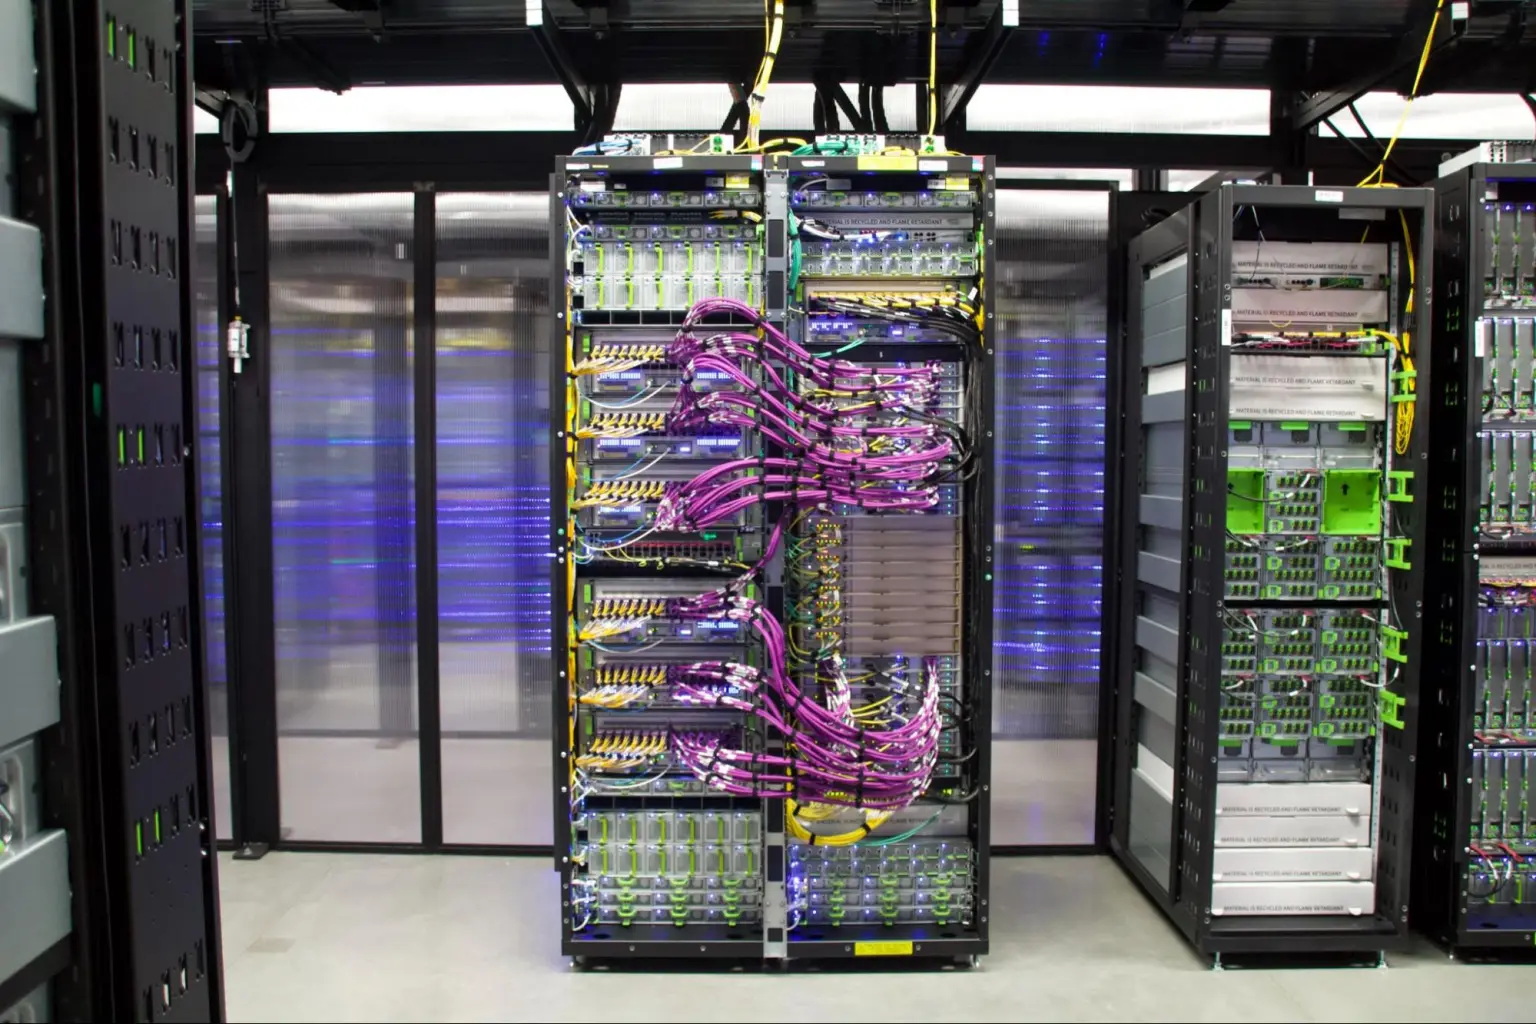
Одна из инженерных особенностей Prometheus — значительные колебания энергопотребления при синхронной работе тысяч GPU. По данным Meta, во время вычислительных циклов нагрузка внутри кластера может изменяться на 30–40%, а запуск или остановка крупных ИИ-задач способны изменить энергопотребление на десятки мегаватт за несколько секунд. Для управления такими нагрузками применяется многоуровневая система, включающая:
- BBU (Battery Backup Units). Аккумуляторные модули на уровне серверных стоек, которые обеспечивают кратковременную поддержку системы электропитания.
- CBU (Capacitor Backup Units). Конденсаторные блоки для сглаживания кратковременных пиков.
- BESS (Battery Energy Storage Systems). Аккумуляторные системы энергонакопления на уровне отдельного здания ЦОД.
- Dynamo Dimmer. Программная система, которая постепенно ограничивает мощность GPU при приближении к установленным лимитам электропотребления.
Совместная работа этих решений помогает уменьшать влияние резких изменений нагрузки как на инфраструктуру кампуса ЦОД, так и на центральную электросеть, а также поддерживать выполнение вычислительных задач без аварийного отключения оборудования.
Сетевая инфраструктура и соединение зданий
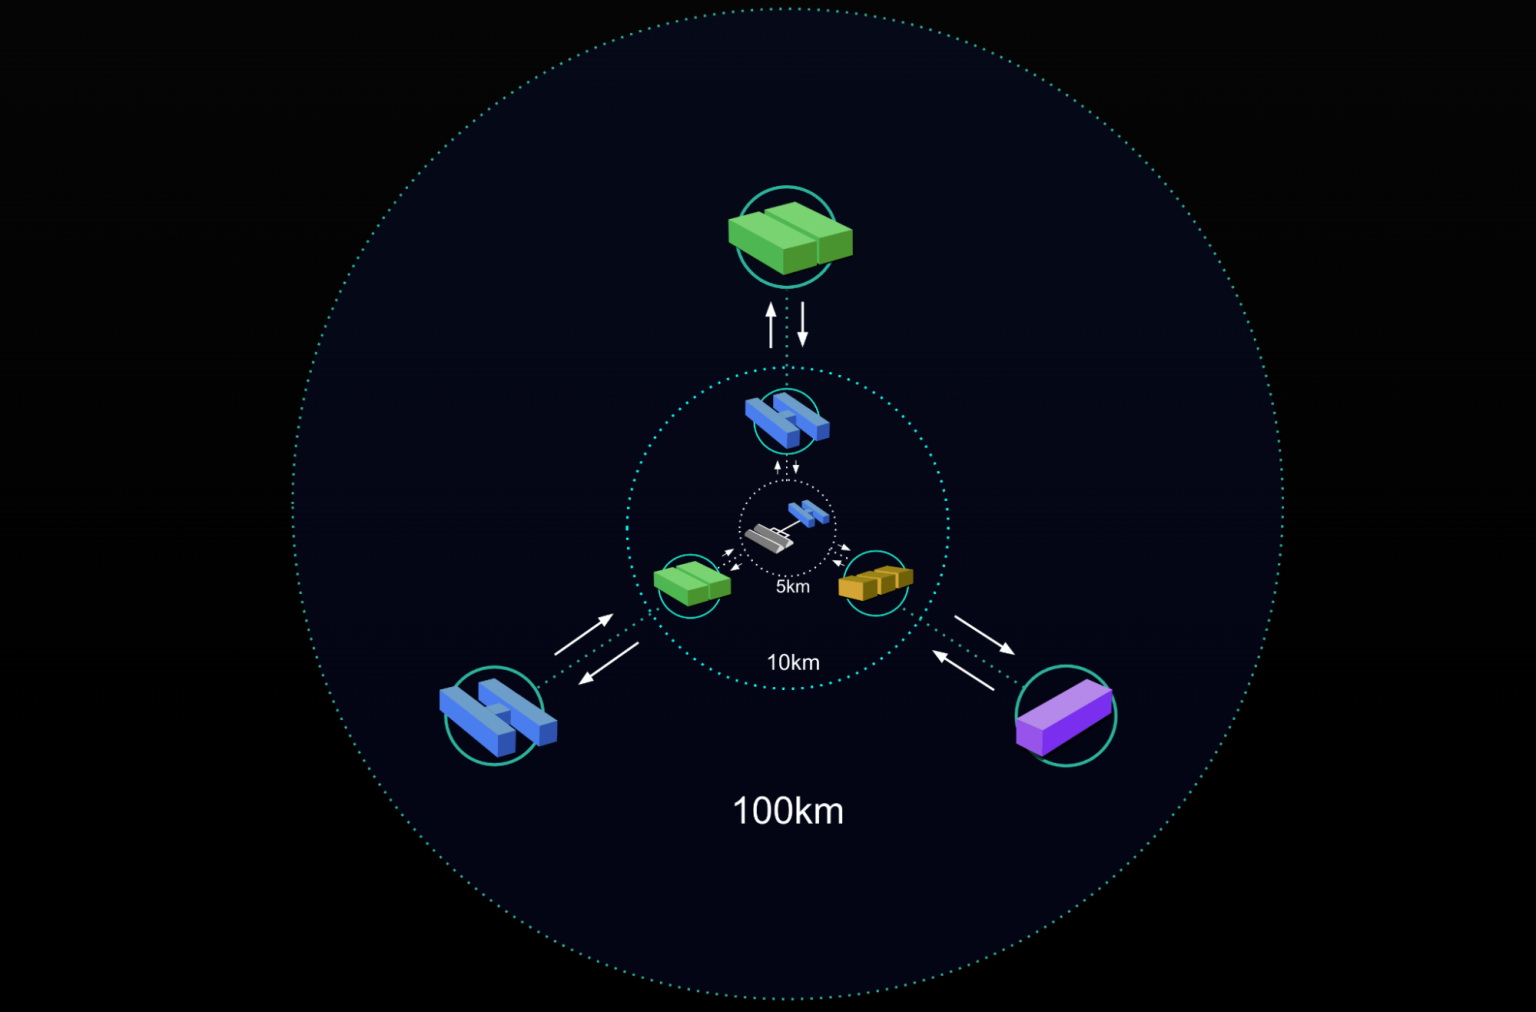
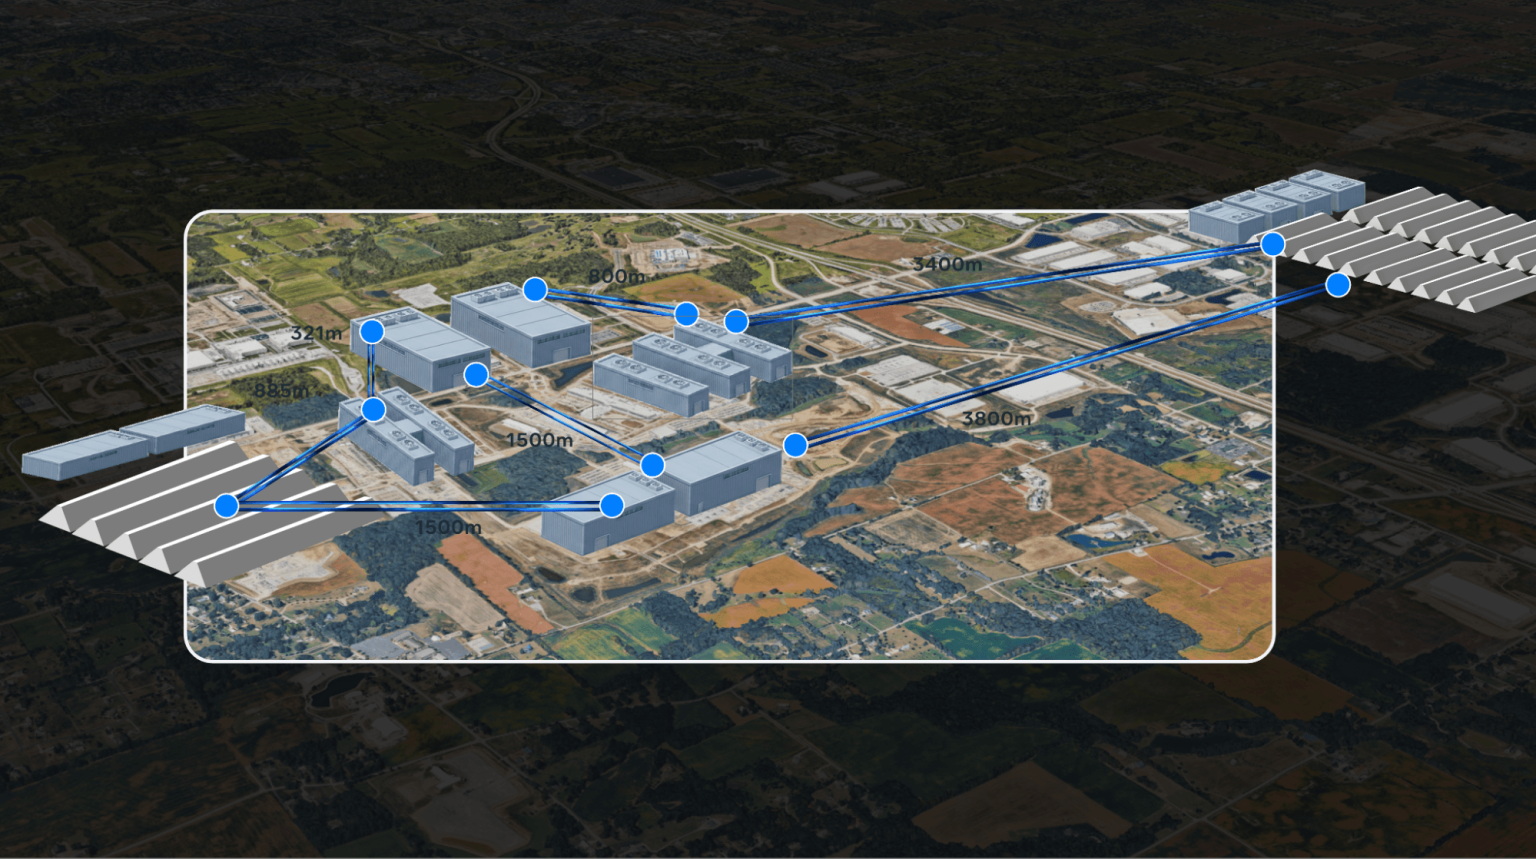
Prometheus представляет собой распределенный вычислительный комплекс. Входящие в его состав здания и отдельные внешние площадки связаны высокоскоростной оптоволоконной сетью.
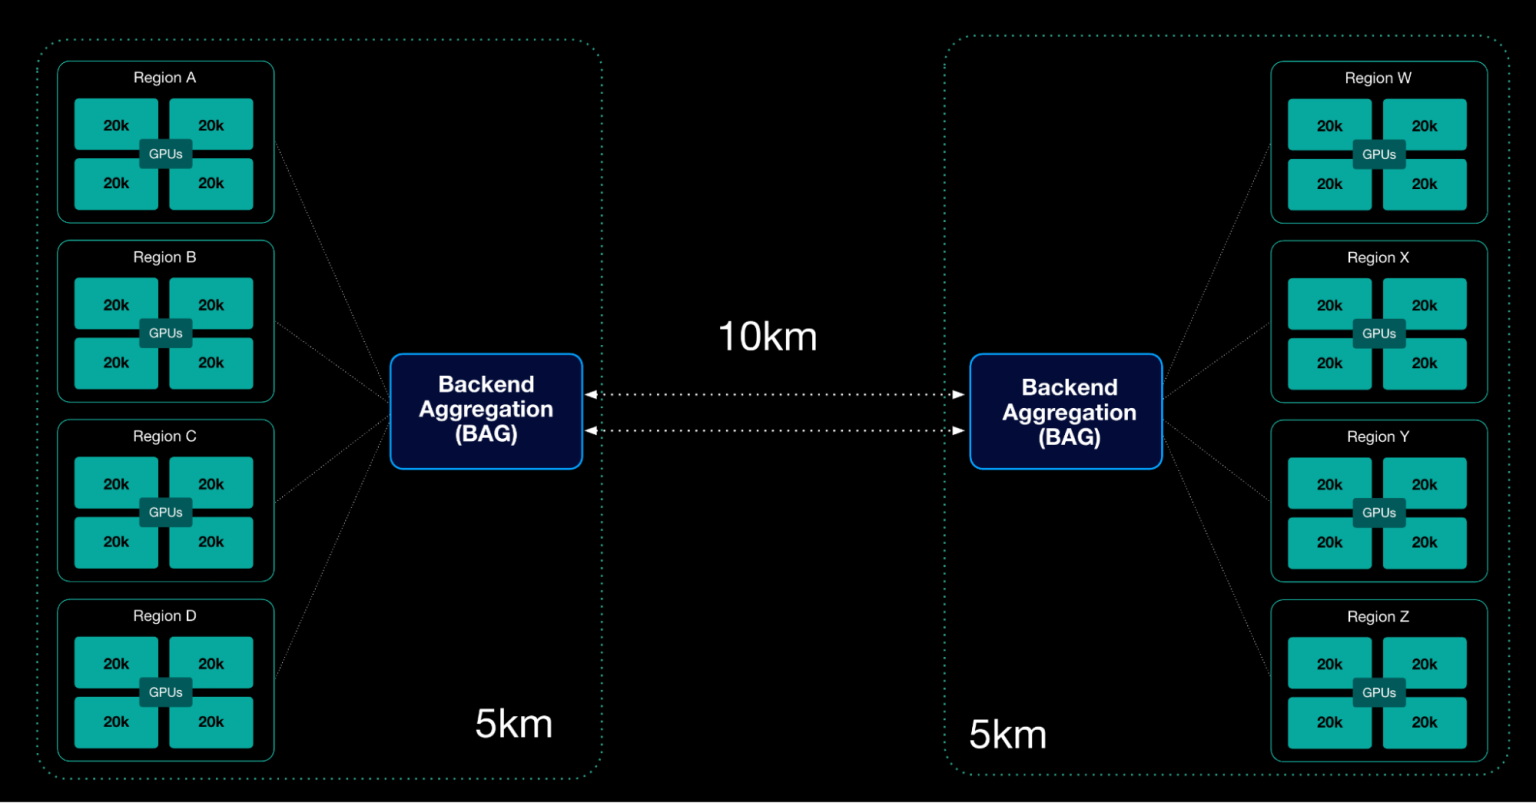
Внутри зданий отдельные сетевые сегменты объединяют кластеры ускорителей, включающие до 20 736 GPU. Между ними проложена магистральная сеть Backend Aggregation (BAG), соединяющая вычислительные кластеры на расстояниях от 2 до более чем 100 км. Такая архитектура позволяет объединять оборудование из разных зданий и площадок в единые пулы для выполнения крупных задач в области машинного обучения.
Дальнейшее развитие комплекса
Первая очередь Prometheus уже работает, однако Meta продолжает расширять вычислительную и инженерную инфраструктуру. Основные направления развития — строительство новых корпусов со специализированной инфраструктурой, внедрение новых поколений жидкостного охлаждения, увеличение мощности серверных стоек и совершенствование инструментов для управления электропитанием.
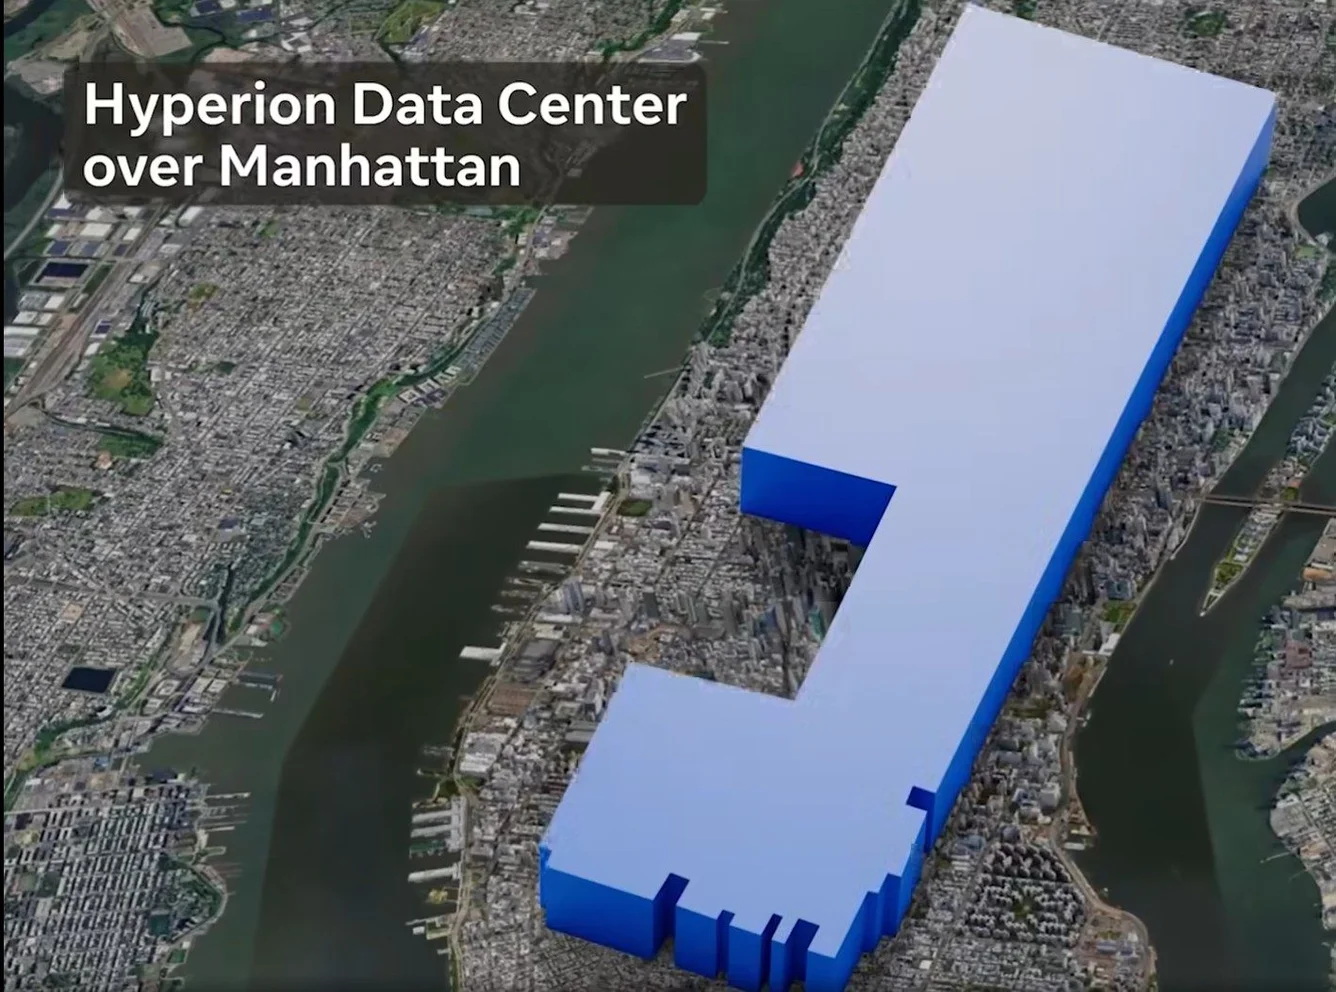
Как сообщает инженерная команда Meta, опыт эксплуатации Prometheus будет использоваться при проектировании следующего крупного ИИ-комплекса Hyperion в Луизиане, где также предусмотрено жидкостное охлаждение с замкнутым контуром.

Всего комментариев: 0